
物理内存永远比所有进程想要的少。内核既不能拒绝合理的分配请求,也不能无限透支,只能把“暂时没人用”的页收回来腾给更紧急的进程,腾内存的这套机制就是页框回收(page reclaim)。
页框(page frame)是物理内存按页划分的分配单位,也是回收的目标。参与页框回收流程的组件有四个:
- 衡量内存紧张程度的水位线:决定了是否触发回收
- 按冷热给页排队的 LRU 链表:决定了应该回收哪些页
- 负责找回所有映射的反向映射:决定了回收的页被哪些进程引用
- 以及匿名页的落脚点 swap 设备:决定了回收后放到哪
其中,回收的对象有两类页:
| 类型 | 例子 | 磁盘上有没有副本 | 回收动作 |
|---|---|---|---|
| 匿名页(anonymous page) | 堆、栈 | 没有,内存是唯一副本 | 首次 swap 先写到 swap 分区才能回收 |
| 文件页(file-backed page) | 代码段、page cache | 有,文件本体就是副本 | 干净页直接丢,脏页先写回 |
最常见的完整的回收路径为:
1 | 进程访问内存 → 缺页 → alloc_pages |
带着三个问题往下读,全文按这三个问题展开:
- 分配内存的进程怎么发现“内存不够”?发现之后由谁收、什么时候收?
- 内核怎么判断一页是热还是冷?
- 被选中的页可能同时映射在多个进程的页表里,怎么拆干净?拆完之后进程再访问这个地址,会发生什么?
1. 从 alloc_pages() 说起
进程申请内存(fork
复制页表、缺页分配物理页),以及内核自身的分配(页表、网络缓冲),最终都汇聚为
alloc_pages() 从伙伴系统(buddy
allocator)领取页框,一次拿走 2^order
个连续页。这条路径有两种命运:
- 内存充足:空闲页数不低于 low 水位线,快速路径直接分配;
- 内存不足:进入慢速路径,先异步唤醒 kswapd 后台回收,仍不够时当前进程同步做直接回收(direct reclaim),最后还有内存压缩与 OOM 兜底。
1 | alloc_pages() /* include/linux/gfp.h,宏 */ |
1.1 回收什么:两类页,五条链
所有可回收页分为匿名页和文件页两类,分别挂在五条 LRU 链上:两类页 ×
冷/热两条链,外加一条不可回收链。五条链挂在 struct lruvec
里,每个 NUMA 节点一份;启用内存 cgroup 后每个 cgroup
再各有一套,限额内的页在组内自己的链上排队。
1 | /* include/linux/mmzone.h */ |
一个页挂哪组链,判据是 folio 上的 PG_swapbacked 标志,为
1 表示这页的后备存储是 swap 空间而不是磁盘文件(如匿名页、shmem
页...):
1 | static inline int folio_is_file_lru(const struct folio *folio) |
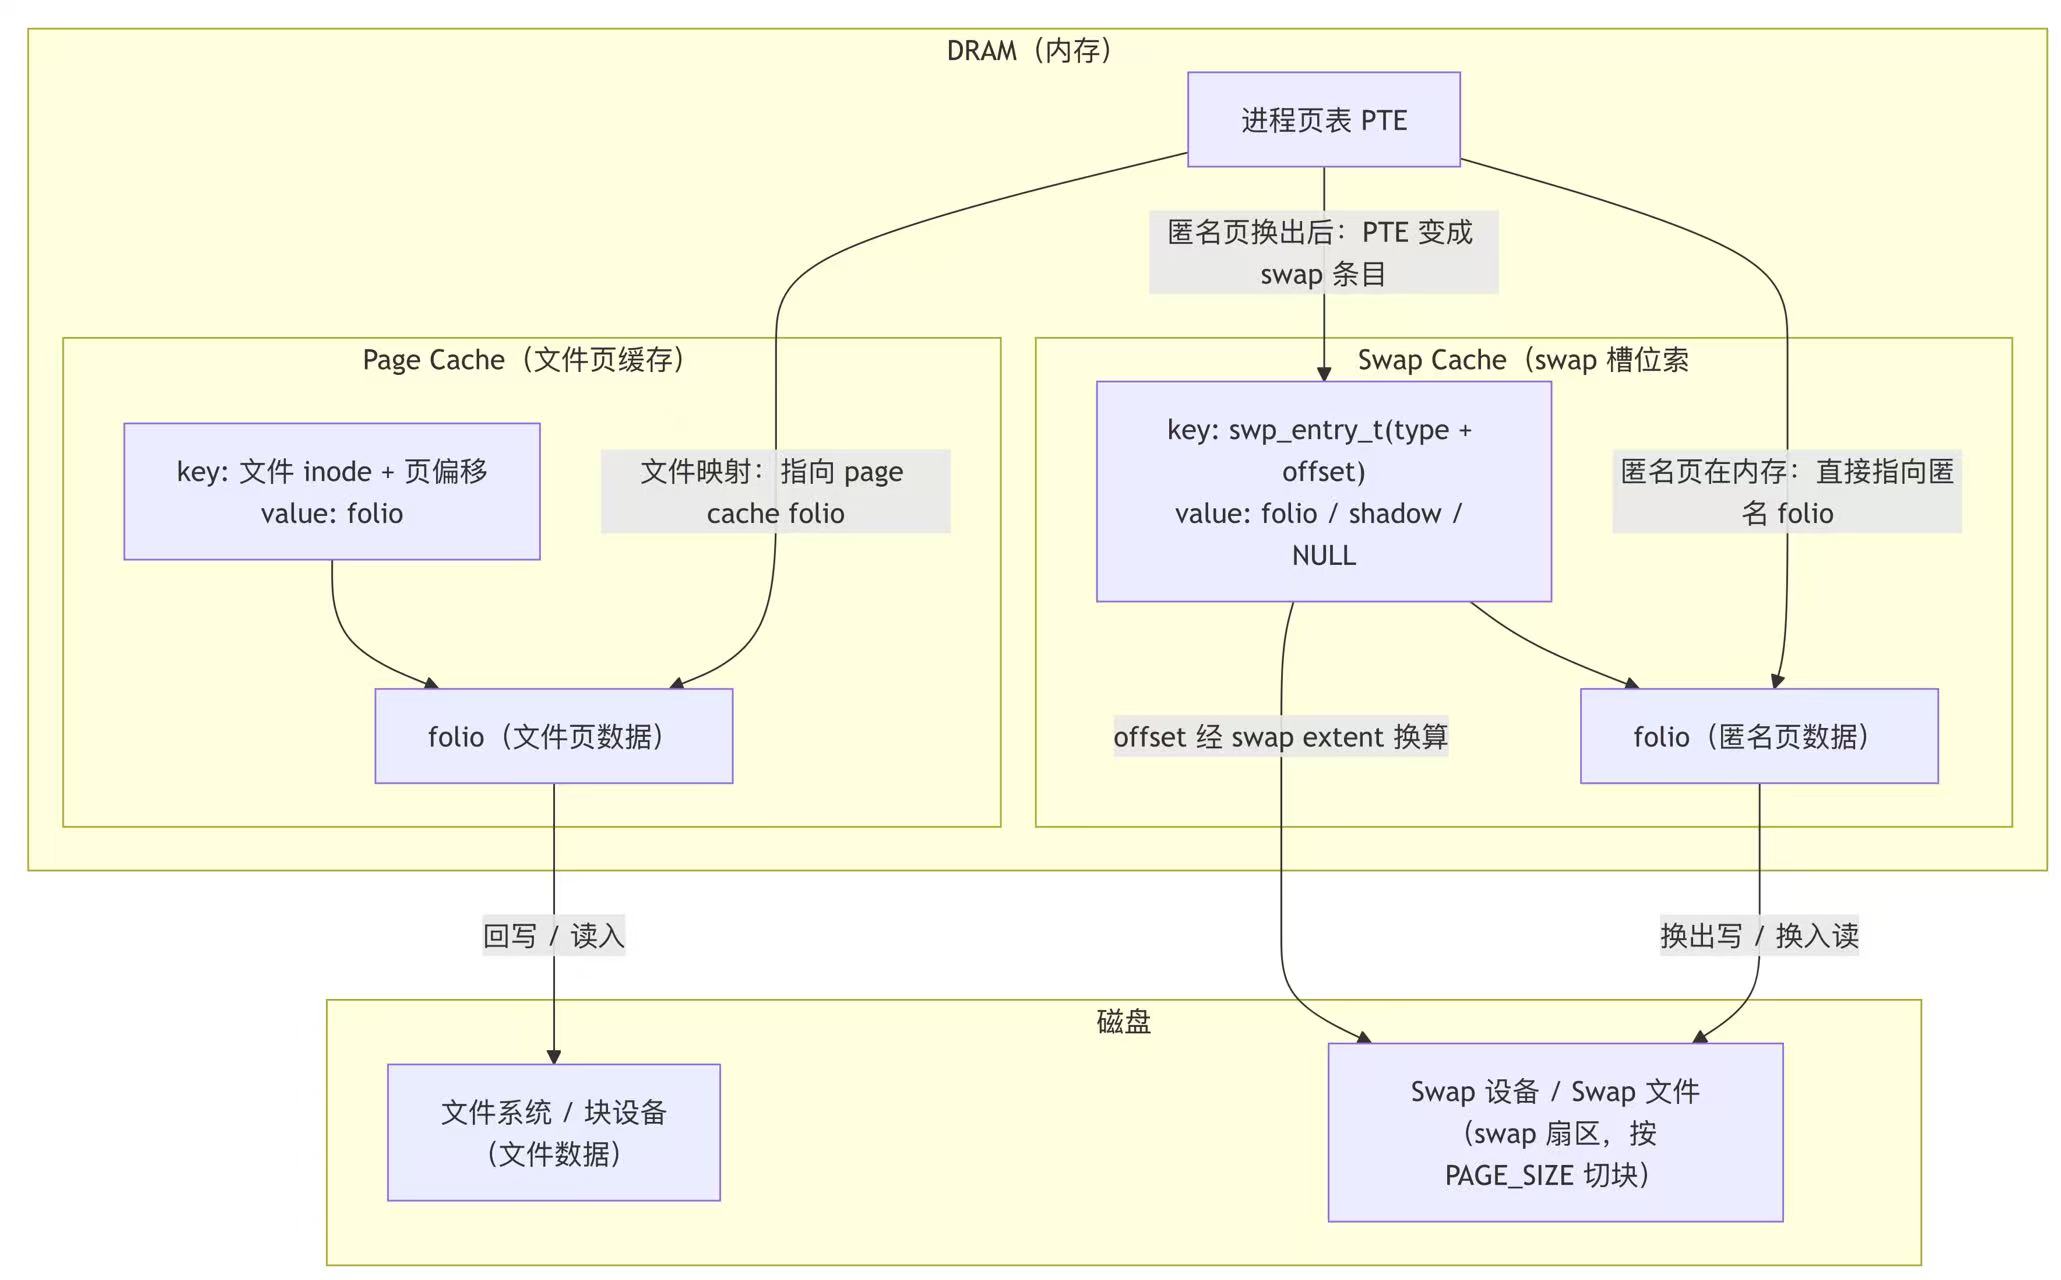
两类页分别在哪里:内存里有 page cache 和 swap cache 两类索引,磁盘上有文件数据与 swap 槽位。
flowchart TB
    subgraph DRAM["DRAM(内存)"]
        subgraph PC["Page Cache(文件页缓存)"]
            PCK["key: 文件 inode + 页偏移
value: folio"]
            PCF["folio(文件页数据)"]
            PCK --> PCF
        end

        subgraph SC["Swap Cache(swap 槽位索引)"]
            SCK["key: swp_entry_t(type + offset)
value: folio"]
            SCF["folio(匿名页数据)"]
            SCK --> SCF
        end

        MM["进程页表 PTE"]
        MM -- "文件映射:指向 page cache folio" --> PCF
        MM -- "匿名页换出后:PTE 变成 swap 条目" --> SCK
        MM -- "匿名页在内存:直接指向匿名 folio" --> SCF
    end

    subgraph DISK["磁盘"]
        FS["文件系统 / 块设备
(文件数据)"]
        SW["Swap 设备 / Swap 文件
(swap 槽位,按 PAGE_SIZE 切分)"]
    end

    PCF -- "回写 / 读入" --> FS
    SCK -- "offset 换算槽位" --> SW
    SCF -- "换出写 / 换入读" --> SW
两类页的回收代价不同,这是后续所有策略的出发点:
- 文件页:磁盘上另有副本。干净文件页直接丢弃,零 I/O;脏文件页需先写回文件。回收开销小。
- 匿名页:磁盘上原本没有副本,首次回收前必须先写入 swap 设备。回收开销大。
所以默认配额下文件链分到的扫描压力(回收数量占比)更高,但两条链都在扫,不是只扫文件。而且该比例也不是一成不变的,而是在回收过程中会持续统计两类页的近期回收成本,然后下一轮
get_scan_count() 计算配额时,按 扫描压力 ∝ 基准权重
÷ 自身近期回收成本
动态调整,近期回收成本越高,分到的扫描配额就越少。
1.2 扫描配额:swappiness 与近期成本
“文件页便宜”也不是绝对的:如果每次收走的文件页很快又被访问,引发重新读盘,开销同样会变大。因此内核的
get_scan_count()
会为两类链各算一个扫描配额,按近期回收成本动态调整。某类页回收越吃亏,下一轮配额越少,扫描压力更多分给成本更低的那条链。
简单记:swappiness 相当于匿名链的权重,(200 − swappiness)是文件链的权重,实际扫描压力 = 权重 ÷ 自身近期回收成本。
几个走极端的场景:
- 没装 swap 或 swap 已用满:匿名页换不出去,配额全额给文件链;
- 临近 OOM:内存快见底,不再精打细算,两条链不加偏向、全力扫描;
- 冷链文件页充足且没在抖动(流式读写文件的典型状态):暂时只扫文件链,不无谓换出匿名页。
1.3 回收的执行:总览
慢速路径确定要回收后,所有回收路径(直接回收、kswapd、主动回收)都在
shrink_node() 汇聚,往下三步:
get_scan_count()按 1.2 的规则算出匿名/文件链各扫多少;isolate_lru_folios()从 inactive 链表尾部,也就是最久没人碰的冷页,批量摘取 32 页;shrink_folio_list()对这批页逐页判定最终归宿。
1 | __alloc_pages_direct_reclaim() /* mm/page_alloc.c,直接回收入口 */ |
整个判定流程一张图看清,细节在后文各节展开:
下面几章的安排:
- §2 回答“什么时候收”
- §3 回答“收谁”
- §4 回答“怎么收”
- §5 回答“收完再访问”
2. 什么时候收:三条水位线与三条路径
2.1 三条水位线
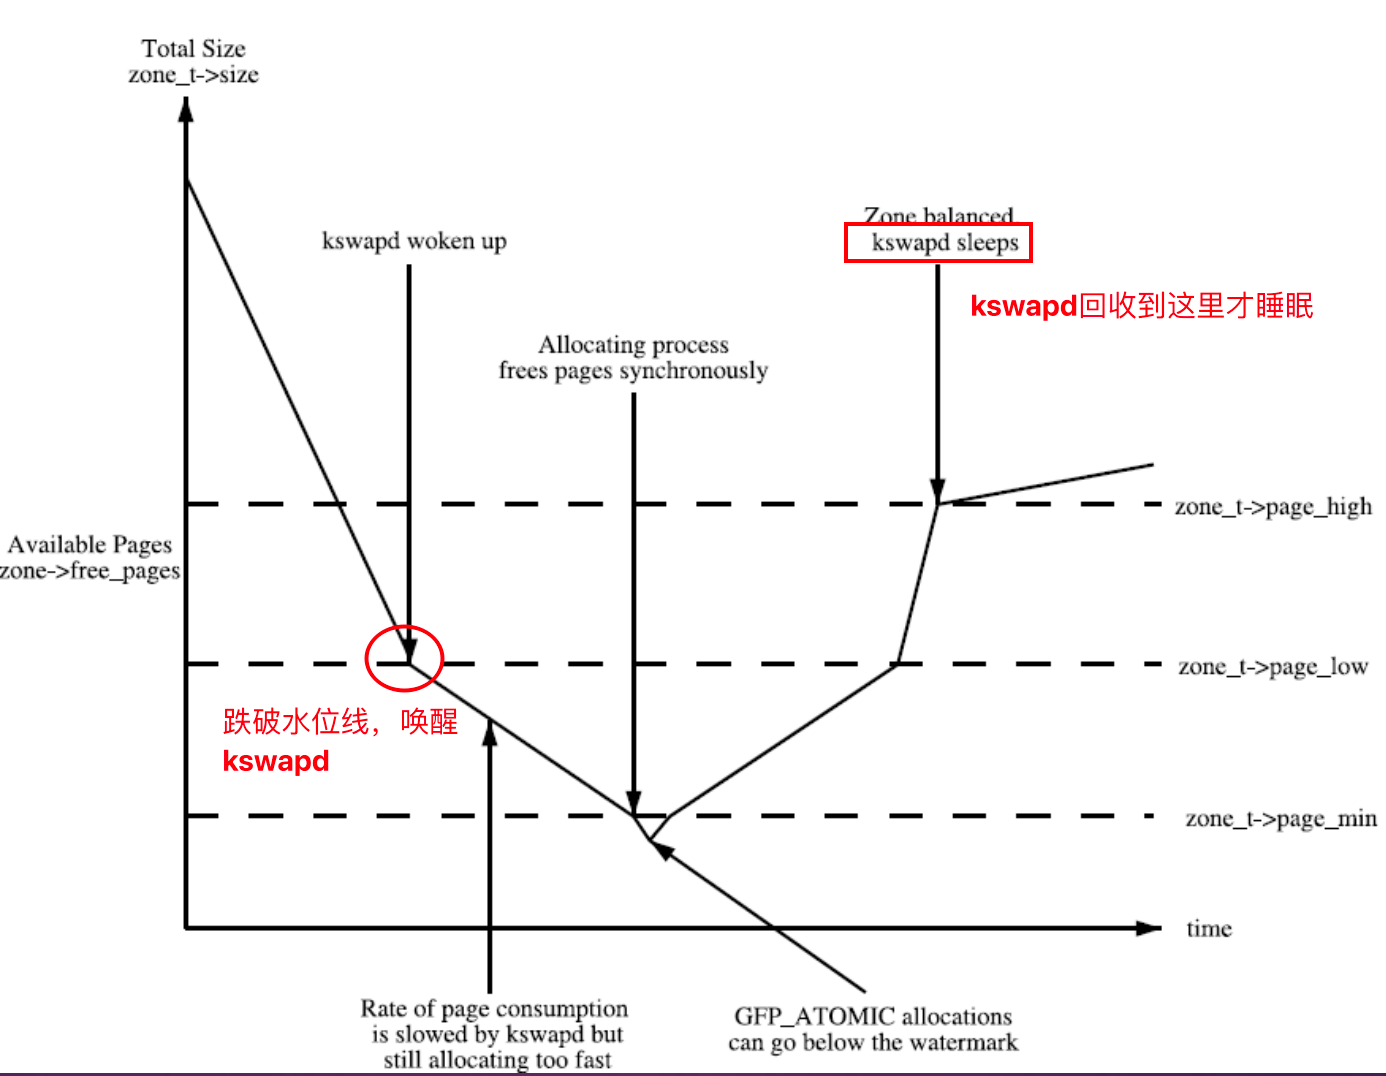
内核用水位线(watermark)衡量每个 zone 的内存紧张程度,三条线刻在
zone->_watermark[] 里,枚举为
WMARK_MIN / WMARK_LOW / WMARK_HIGH:
1 | zone 空闲页数随消耗不断下降 ──────────────────────────► |
2.2 路径一:kswapd 后台回收
kswapd 是每个 NUMA 节点一个的内核线程,sleep
在该节点的等待队列上。它是被动唤醒的:没有定时器,不做巡检,只有
wakeup_kswapd() 显式叫它才干活。
- 分配路径跌破 low 水位时唤醒
- NUMA balancing 页迁移失败时也唤醒。
唤醒后执行 balance_pgdat(),把所有 zone 回收到 high
水位以上。达到目标后先以 HZ/10
的假睡试探,期间没人再叫才进入深睡。试探期顺手叫醒 kcompactd
做碎片整理:回收只把页变“闲”,THP
这类高阶分配还需要“连续”,整理交给专职线程。
2.3 路径二:直接回收,慢速路径的兜底
分配内存时,内存水位线低于 low 会走,慢路径
__alloc_pages_slowpath(),策略是先礼后兵、层层加码:
- 第一级:叫醒 kswapd 异步回收,同时把 alloc 分配线放宽到 min 水位,立刻重试分配内存。刚跌破 low 时离 min 还有整段缓冲,这一试多半当场成功,缺口交给 kswapd 在后台慢慢补;
- 第二级:真跌破 min 且重试失败,才亲自下场做同步的直接回收。调用进程自己变成回收器,扫 LRU、发换出 I/O 并等它完成,阻塞发生在自己身上,连续 16 轮零产出才认为失败;
- 第三级:OOM killer 按 oom_score 挑最占内存的进程杀掉,腾出内存再回来重试;仍不行则分配返回 NULL。
这里讲个题外话,OOM 计算准备 kill 的进程也是有算法的,oom_score 计算因素(oom_score 分数越高越容易被回收):
- 内存占用:分数 ≈ RSS + swap 条目 + 页表占用,占用越多分越高
- oom_score_adj:手动调整(-1000 到 1000),唯一的加减分手段
同时,也可以主动查看和调整进程的 oom_score:
1 | 查看进程OOM分数 |
2.4 路径三:主动回收
前两条路径都是被内存压力逼出来的,第三条是用户主动指定“收这里的内存”:
| 触发方式 | 调用链 | 特点 |
|---|---|---|
madvise(MADV_PAGEOUT) |
madvise_pageout() → reclaim_pages() |
用户指定地址范围,绕过 LRU 挑选直达逐页判定 |
写 cgroup 的 memory.reclaim |
try_to_free_mem_cgroup_pages() →
shrink_node() |
写"64M"就收 64M |
| DAMON | damon_pa_pageout() → reclaim_pages() |
内核自动采样识别冷的物理地址区域 |
2.5 三条路径对比
| kswapd 后台回收 | 直接回收 | 主动回收 | |
|---|---|---|---|
| 触发条件 | 分配内存时空闲页 < low(被动) | 分配内存时慢速路径兜底(被动) | 用户/策略显式发起 |
| 执行者 | 后台内核线程 | 当前分配进程 | 发起调用的进程 |
| 对业务的影响 | 业务无感 | 阻塞当前分配 | 阻塞调用者 |
| 挑页方式 | LRU 扫描 | LRU 扫描 | 用户指定范围 / DAMON 识别 |
“什么时候收”到此解决,剩下的核心问题是“收谁”。
3. 收谁:LRU 链上的冷热页判决
直觉上应该收“最久没人用的页”,LRU(Least Recently Used,最近最少使用)链就是按这个原则给页排队的:最近用过的靠热端,久未使用的沉到冷端,回收从最冷处下手。每条链都是双向链表,链头是热页,链尾是冷页,新页从链头进,回收从链尾摘:
1 | active 链(热) |
3.1 冷热的证据:PTE AF 与 folio PG_referenced
LRU 判断冷热的依据从哪来?页被访问时硬件不会去动链表,而是内核会根据跟冷热链相关的位有两个来调整页所放的链(冷链 or 热链):
| 位 | 是什么 | 谁置 1 | 谁清 0 |
|---|---|---|---|
| PTE AF(Access Flag,访问标志) | 硬件侧:每个映射该页的进程各有一份 | 缺页装配 PTE 时软件置 1,之后硬件自动维护 | 回收器沿反向映射(§4)扫所有 PTE 清 0 |
| PG_referenced | 软件侧:整个物理页一份 | 访问路径报告访问时置 1 | 晋升 active 时清 0 |
内存访问缺页时,刚建立页表的时候,会无偿给该页置 AF=1,首次申请该物理页时,会先把这个 folio 页放到 inactivate 链中。
回收扫描扫到一页时,会先沿反向映射看一眼映射到这个页的所有 PTE 的 AF位,并把 AF 位清 0、PG_reference 置 1,只要扫描过程中有一个 AF = 1,就会给第二次机会,放回 inactive 链头重新排队,而不是直接回收。下次该页重新排到链位的时候,再次扫描:观察窗内 AF 又变成 1,说明真有人用,晋升到 active 链中;AF 仍是 0 的话,才被认为是真冷页,进入回收。
简单来说,从 inactivate 链晋升到 activate 链的依据就是:AF=1 且 PG_referenced=1
我们给页第二次机会重新返回 inactivate 链头这套机制防的是误杀热页:正在用的页被收走,进程立刻缺页把它换回来,内存没省多少,反而多了 CPU 和 I/O 搬运的开销上,这就是抖动。
3.2 动画:一个页的一生
下面这个交互动画把一个匿名页从出生到回收的完整一生逐步走一遍,重点看 AF 和 PG_referenced 两位怎么配合,建议单步播放:
3.3 状态机全景
把上面的循环画成状态机,以匿名页为例:
- 出生:写缺页分配新页(读缺页直接映射共享零页,不分配),挂 inactive 链头,PTE 自带 AF=1,folio 上只有 PG_swapbacked;
- 爬升:第一次访问置 PG_referenced,第二次访问晋升 active;
- 老化:
shrink_active_list()从 active 链尾把长期不动的页降级,送回 inactive 链头重新排队; - 回收:冷到链尾且无人引用,进入换出流程(§4);
- 换回:再被访问时
do_swap_page()换入(§5)。
热链也不是保险箱。被降级的热页会带上 PG_workingset 标志,回收后在索引里留下“影子条目”记录死亡时间;下次换回时用时间差判断这次换入是正常缺页还是热页被误杀的抖动,后者直接放回热链,算是抖动的第二道保险。
文件页的一生与上面完全同构,差别只在归宿:page cache 里的页始终有磁盘副本,干净页回收等于丢弃,唯一需要 I/O 的是脏页。而脏页的落盘不发生在回收路径里,这是下一章的重点之一。
4. 怎么收:反向映射与三类归宿
4.1 为什么需要反向映射
页表只存正向 VA→PA。可回收器拿到的是物理页(folio PA),它要做的两件事都需要反方向找到映射到 folio 的所有 PTE 的信息:
- 判冷热要清 AF:任何一个映射该页的 PTE 的 AF=1,都该给它第二次机会(§3.1);
- 回收要拆映射 unmap:这页可能同时映射在多个进程的页表里(fork 之后子进程共享父进程的页,多个进程 mmap 同一个文件),必须把所有 PTE 拆干净才能释放。
没有反向索引,唯一的办法是遍历所有进程的页表(16GB 内存 ≈ 400 万条 PTE),代价不可接受。内核的解法是给每个 folio 挂一份能找回所有相关 VMA(Virtual Memory Area,虚拟内存区域)的索引,这就是反向映射(reverse mapping,rmap)。
反向映射的产出很明确:我们需要找到所有 (进程, 虚拟地址 VA) 对。进而通过 VA walk 找到 PTE。
这里涉及的就有两类页的反向映射结构:
1 | 匿名页: folio -> anon_vma <- anon_vma_chain -> vma(fork 各代) |
4.2 怎么通过反向映射计算出VA:先枚举 VMA,再换算地址
物理页自己不记录任何虚拟地址。文件页可以通过
folio->index 直接静态换算出来。
第一步:PA → folio
PA 先转成页帧号 pfn = PA >> PAGE_SHIFT,再用
pfn_to_folio(pfn)(或 pfn_to_page() 后
page_folio())拿到 struct folio *folio。
第二步:从 folio->mapping
找到反向映射链表
- 若
mapping低位带PAGE_MAPPING_ANON标记 → 匿名页,去掉标记得到anon_vma。 - 否则 → 文件页,
mapping就是文件的address_space。
第三步:从反向链表可以找到映射到该 folio 的所有 vma
- 文件页:在
address_space->i_mmap区间树里,按folio->index(页在文件中的偏移)查找,找到覆盖该偏移的 VMA。 - 匿名页:遍历
anon_vma下挂的anon_vma_chain,逐个检查 VMA 是否真的映射了这个 folio(算出地址后验证对应 PTE 的 pfn 是否匹配)。
第四步:算出 VA
文件页:
text
1
vaddr = vma->vm_start + (folio->index << PAGE_SHIFT) - (vma->vm_pgoff << PAGE_SHIFT)
含义:folio 在文件中的偏移,减去 VMA 起始的文件偏移,得到 folio 在 VMA 内的相对偏移,再加上 VMA 的虚拟起始地址。
匿名页:
text
1
vaddr = vma->vm_start + ((folio->index - vma->vm_pgoff) << PAGE_SHIFT)
匿名页的
folio->index记录的是它在 VMA 内的页索引(相对vm_pgoff),直接算相对偏移再加vm_start。
第五步:用 VA 执行页表 walk PGD→PUD→PMD→PTE 拿到 PTE。
第六步:验证 pte_pfn(pte) == pfn,确认命中了该物理页
5. 再访问:换回内存
回收把映射拆了,页框也还给了伙伴系统。进程下一次访问这些虚拟地址,答案是缺页。这一章讲怎么换回来。
5.1 拿 VA 怎么找到 swap 里的内容
缺页后,我们只有存着一个 VA,怎么通过 VA 去 swap 分区中找到我们要的数据呢?
- VA 只负责走页表,定位到那个 PTE 槽;
- swap 位置信息是换出时内核预先写进 PTE 槽里的 (type, offset) 编码。
1 | VA --走页表(PGD->PUD->PMD->PTE)--> 那个 PTE 槽 <- 第一段:VA 只干这个 |
缺页时这个走表过程发生两次:MMU 的 page table walker 硬件走一次,发现
present=0,触发 translation fault(缺页异常);异常处理里
handle_mm_fault()
软件按同样的位段索引再定位一次,读出槽里的值。注意软件这次只是读取定位,不分配任何页表:页表常驻内存、不会被换出,只要
swap entry 还在槽里,整条路径必然完整存在。
5.2 do_swap_page()
1 | 缺页异常(PTE 为 swap entry) |
5.3 拿到的是新的物理页吗
多数情况下是。回收本来就意味着旧页框已归还伙伴系统,可能早被别人用掉,换入的新 folio 从伙伴系统领取新页框,内容从 swap 读入。例外是缓存恰好还留着原 folio:
- fork 的多个子进程先后访问同一个已换出的页:第一个 fault 的进程换入新页并放进 swap cache,folio 留在里面,其余子进程 fault 时 swap cache 命中,直接映射同一个物理页,谁要写谁走 COW(Copy On Write,写时复制);
- 文件页重访时 page cache 还留着该页,比如别的进程仍映射着,或回收尚未轮到它:直接映射原页,零 I/O。
总结
- 页框回收的入口是分配本身:空闲页跌破 low 水位,分配路径唤醒 kswapd 异步回收;跌破 min 仍不够,分配进程自己同步直接回收,最后 OOM killer 兜底。
- 回收对象分匿名页和文件页两类,各挂一套 active/inactive LRU 链,扫描压力按 swappiness 权重和两类页的近期回收成本动态分配。
- 冷热判决靠 PTE AF 和 PG_referenced 双轨证据:回收扫描清 AF,观察一个窗口,第二次还被访问才晋升热链。第二次机会防的是误杀热页造成抖动。
- 拆映射靠反向映射:文件页走 address_space 区间树、匿名页走 anon_vma 锚点枚举所有 VMA,用 folio->index 换算回各进程的地址,逐个操作 PTE。
- 归宿三分:干净文件页直接丢,脏文件页置 PG_reclaim 等回写线程异步落盘,匿名页换出到 swap。再访问时缺页,按 PTE 里预埋的 swap entry 换回。
参考:页框回收