
源码基线: Linux 7.2-rc7 + BBML3 系列 patch(含 Mikołaj Lenczewski 的 BBML2 四部曲
3eb06f6ce3af/5aa4b625762e/212c439bdd8f/83bbd6be7d17,以及 BBML3 演进f8d0751426dd/267b481d0b94/06468bc3c936/4955df16ff99)视角约定: MMU 侧指 PE 自己的地址翻译硬件——包括 stage1(进程/内核页表)和 stage2(KVM 给虚机配的第二级翻译)。SMMU/IOMMU 是另一套翻译器,只在对照处出现
一、BBM 基础
1.0 全文概览
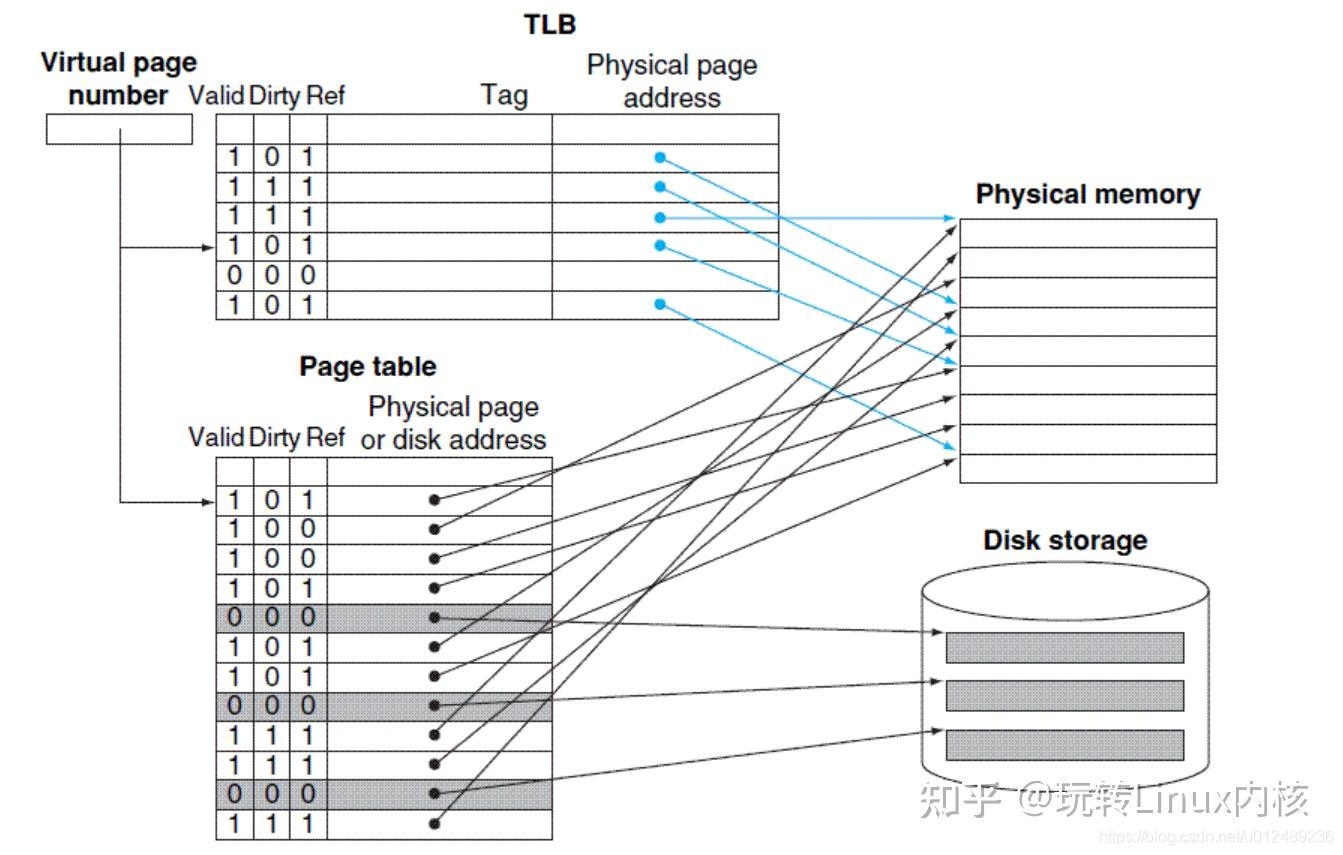
1.1 两个对象:页表 entry 与 TLB entry
BBM(Break-Before-Make) 的含义是在写入新 PTE(Make)之前,先把旧 PTE 置 invalid 并刷新 TLB(Break)。
Break这个动作同时作用于两个对象:
- 页表 entry(源头):存在内存中,软件可写; → 旧 PTE 置 invalid 的操作对象
- TLB
entry(缓存副本):硬件持有,软件不能直接写,只能用
TLBI 指令驱逐。 → TLBI 刷新 TLB 的操作对象
- RFFWJK(TLB 无硬件一致性):data cache 有 MESI 协议自动维护一致性,TLB 没有——页表改了,硬件缓存不会自动跟着改。
两者的关系如下图:
其中,TLB entry 不只是"TLB 里的翻译缓存"——任何持有页表 entry 的结构都算,包括中间级 walk cache 和 walk 硬件的临时寄存器(RRVJDB);
Per-CPU 私有 TLB: MMU 是每核私有的,TLB(包括 L1 I/D-TLB 和 L2 unified TLB)也是每核私有、不共享。跨核同步靠 TLBI 广播(IS 后缀 = Inner Shareable)。
1.2 TLB 查找与 multi-hit 机理
TLB 里存的是页表翻译后的结果。一个 TLB entry 由三部分组成:
- 键(Tag)
- VA/IPA 高位
- 覆盖大小
- 翻译上下文(RNWYRD)
- Security state
- 翻译 regime
- VMID(stage2)
- global/非 global
- ASID(非全局)
- 示例:
VA[47:21]=0x91, size=2MB, VMID=0x5
- 值(Value)
- OA/PA 页帧(位宽随粒度变化)
- 示例:
PA[47:21]=0x6789A
- 属性
- AP/UXN/PXN/S2AP/XN、AttrIndx(内存类型)、SH、nG、Contiguous、AF、DBM
- 示例:RW, User, WB-cacheable, AF=1
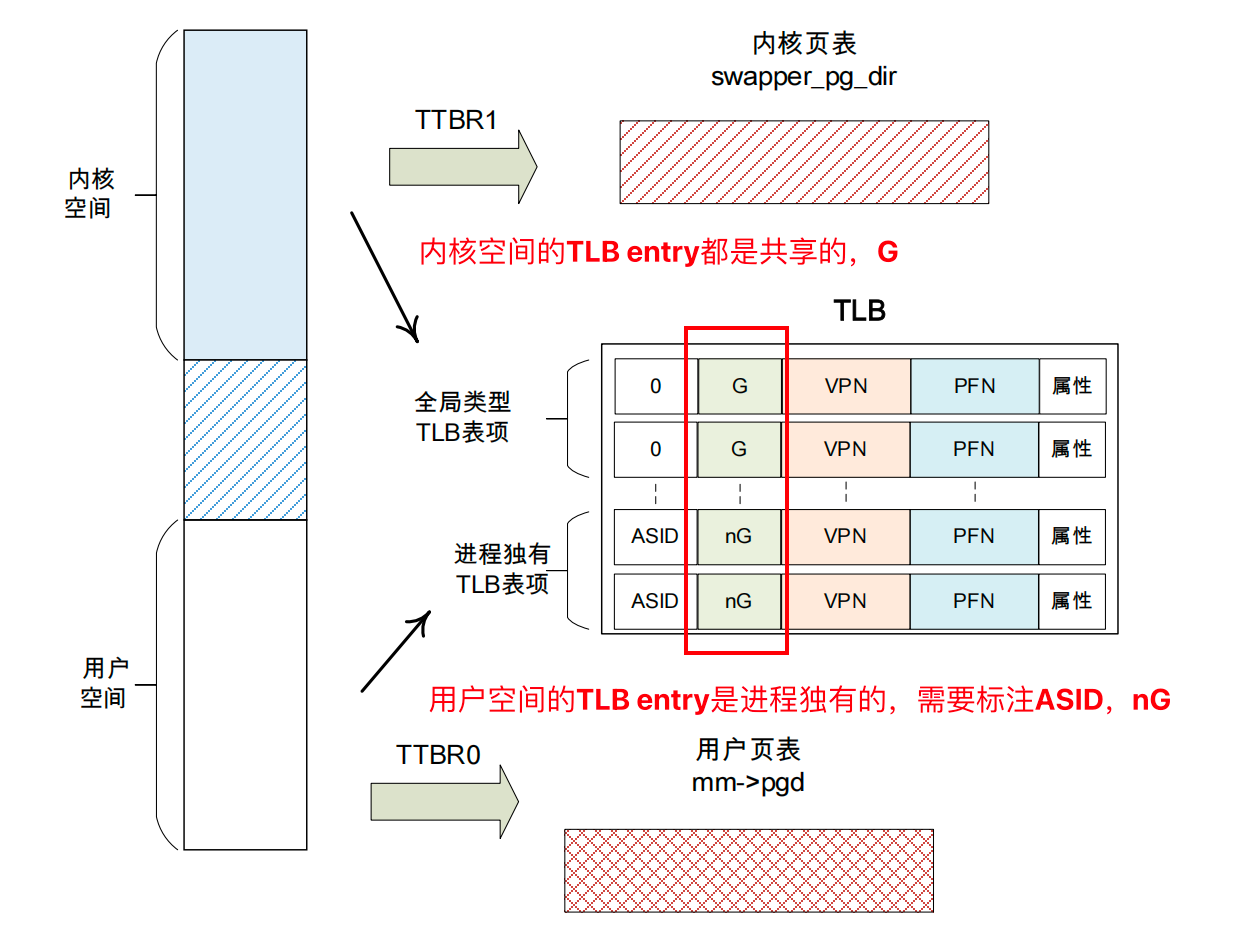
TLB 区分 block 和 L3 page,依据就是键里的覆盖大小,页表中各级叶子节点在 TLB 中的存储(4KB granule、48-bit VA)格式如下所示:
- L1 Block(1GB): 键=
VA[47:30]+ size=1GB + 上下文,值=PA[47:30](18 bit 页帧),偏移=VA[29:0] 透传 - L2 Block(2MB): 键=
VA[47:21]+ size=2MB + 上下文,值=PA[47:21](27 bit 页帧),偏移=VA[20:0] 透传 - L3 Page(4KB): 键=
VA[47:12]+ size=4KB + 上下文,值=PA[47:12](36 bit 页帧),偏移=VA[11:0] 透传
walk cache 存的是非叶子 Table descriptor(指向下一级页表的指针):键是 Table descriptor 的地址 + 翻译上下文。walk 到某级时若该级 Table entry 已缓存,直接拿到下一级页表地址,省一次内存读操作。
TLB 查找的真实机制——CAM 并行掩码比较:
- 不是从 VA 算一个 tag 查哈希表——那样不同粒度 = 不同 key,无法同时命中;
- 也不是遍历所有 size 逐个试——没有循环,没有顺序逻辑;
- 真实机制:VA 同时广播到所有 entry,每条 entry 用自己的 size 派生掩码在同一时钟周期内独立完成比较;
- tag 和掩码在填充时随 walk 结果写入 entry:walk 到 L2 Block → 带 2MB 掩码;walk 到 L3 Page → 带 4KB 掩码。
VA 0x12340000 同时匹配 2MB 和 4KB 两条 entry 的过程:
| entry | 粒度 | 掩码 | 比较结果 | 命中 |
|---|---|---|---|---|
| [0] | 2MB | VA[47:21] | 0x91A0 = tag | ✓ |
| [1] | 4KB | VA[47:12] | 0x12340 = tag | ✓ |
| [2] | 2MB | VA[47:21] | 0x91A0 ≠ tag | ✗ |
2MB 范围与 4KB 范围是包含关系——同一个 VA 同时落在两者之内,两条 entry 同时报告命中 = multi-hit。
1.3 multi-hit 的正确推导:merge 方向
页表修改操作中,需要 BBM 的根因是为了防止一个 TLB 中出现多个 entry 命中同一个 VA 的情况(multi-hit)。
split 方向(大变小)推不出 multi-hit(单 PE 私有 TLB):
- 旧 2MB entry 在 TLB 中 → 所有访问在 2MB 范围内都 hit → 不产生 walk → 不会填充新 4KB entry;
- 旧 2MB entry 被淘汰 → 只有新 4KB entry 被填充 → 不同 4KB entry 之间互不重叠 → 无 multi-hit。
merge 方向(小变大)才能推出 multi-hit:
- 旧 4KB entry 只覆盖自己的页 → 对兄弟页的访问 miss → walk → 填充新 2MB entry;
- 新 2MB entry 的覆盖范围包含旧 4KB entry 的页 → 同一 VA 双命中。
如果硬件不支持 BBML2,且软件不按 BBM 顺序,比如先 make 再 break,就会产生 multi-hit:
- 初始: 512 个连续 4KB 页(L2 Table → 512 个 L3 PTE)。CPU 之前访问过页 #0(VA 0x12340000) → TLB 缓存了 4KB entry(只覆盖页 #0)。
- 软件直接改页表: L2 Table entry → Block entry(2MB)。不 invalid、不 TLBI。但硬件只实现 BBML0(无 BBML2 消解能力)。
- CPU 访问页 #1(VA 0x12341000): 旧 4KB entry 覆盖不住页 #1 → TLB miss → walk → 读到 L2 Block(2MB) → 填充 2MB entry 到 TLB。
- TLB 两条并存: 旧 4KB(页#0) + 新 2MB(覆盖#0~#511)。
- CPU 再次访问页 #0: 4KB entry 匹配(VA[47:12]) AND 2MB entry 也匹配(VA[47:21]) → MULTI-HIT!
交互演示: 逐步体验 merge 方向 multi-hit 的全过程——从初始 4KB entry 到 BBML2 式直接改页表,再到 walk 填充 2MB entry,最后 multi-hit 及 BBML0 硬件无法处理的灾难:
BBML0 硬件对 multi-hit 的处理方式: CONSTRAINED UNPREDICTABLE — 可能 TLB conflict abort,可能融合两条 entry 的属性(危险: 权限/内存类型拼凑),可能返回错误翻译。系统出错!
这就是 BBM 存在的根本原因: 杜绝 multi-hit。
Merge 的第二个危害: walk cache use-after-free:
- Walk cache 缓存了L2[j] = Table → L3@Page;
- Merge 后 L2[j] = Block,L3 页表被释放;
- PE 的下次 walk 使用 stale walk cache 指针 → descend into freed L3 page → 读垃圾 PTE → 错误翻译或 fault。
Split 方向无此危害: L2 Block → Table,L2 page 本身没变,walk cache 指向 L2 page 的指针仍然有效。
为什么架构对两个方向都要求 BBM:
既然 split 方向不会 multi-hit,为什么 RWHZWS 还要求 BBM?
- Stale entry 掩蔽后续 per-page 修改(todo: 占个位,实际上并没有想清楚为什么split需要BBM) : Split 后软件通常要改单个 PTE 的权限/OA(如写保护脏页跟踪)。如果 stale 2MB entry 不失效,后续 per-page 修改对 hit 该 entry 的 PE 无效 → 数据损坏/权限绕过;
- 架构一刀切: 架构不区分方向,统一要求 BBM 最安全。软件不用逐方向分析。
1.4 BBM 六步序列 (RDDMVT)
BBM 由两大阶段组成——先 Break(断旧,①~④)再 Make(建新,⑤~⑥),编号对应 ARM定义的六步序列(RDDMVT):
- ① 旧 entry 置 invalid(Valid=0): 不允许再 walk 这个页表项——但此时旧 TLB entry 仍然有效,对它的访问是无害的;
- ② DSB: 确保 ① 的 invalid 写对其他 PE 可见;
- ③ 广播 TLBI: 驱逐所有核的 TLB 中已缓存的旧 entry——此后 TLB 命不中、页表也已是 invalid, 而 walk 被拒,没有任何途径还能访问到旧 entry;
- ④ DSB: 确保 ③ 的驱逐广播完成——此刻 TLB 里该地址的 entry 为空;
- ⑤ 写新 entry(Valid=1): 从页表源头建新——后续 walk 读到新翻译;
- ⑥ DSB: 确保 ⑤ 的新 entry 对其他 PE 可见——后续 miss → walk → 填充新 TLB entry。
[④, ⑤) 窗口期:Break 完成、Make 尚未执行的间隙,内存中 entry invalid + TLB 已驱逐——任何访问都得到 Translation Fault。这不是 lock 等待,而是硬件触发异常,靠 fault handler 兜底。
窗口期的 fault 抖动正是 BBML1 出现的动机之一——BBML0 的 fault 窗口对不可停的 DMA 流(网卡/GPU)是致命的,设备不会像 CPU 一样走 fault handler 重试。
那么,我们就可以来推导一下,为什么严格的 BBML0 在多核场景下,针对修改OA等场景,为什么绝对不会导致访问到空页等情况出现了。
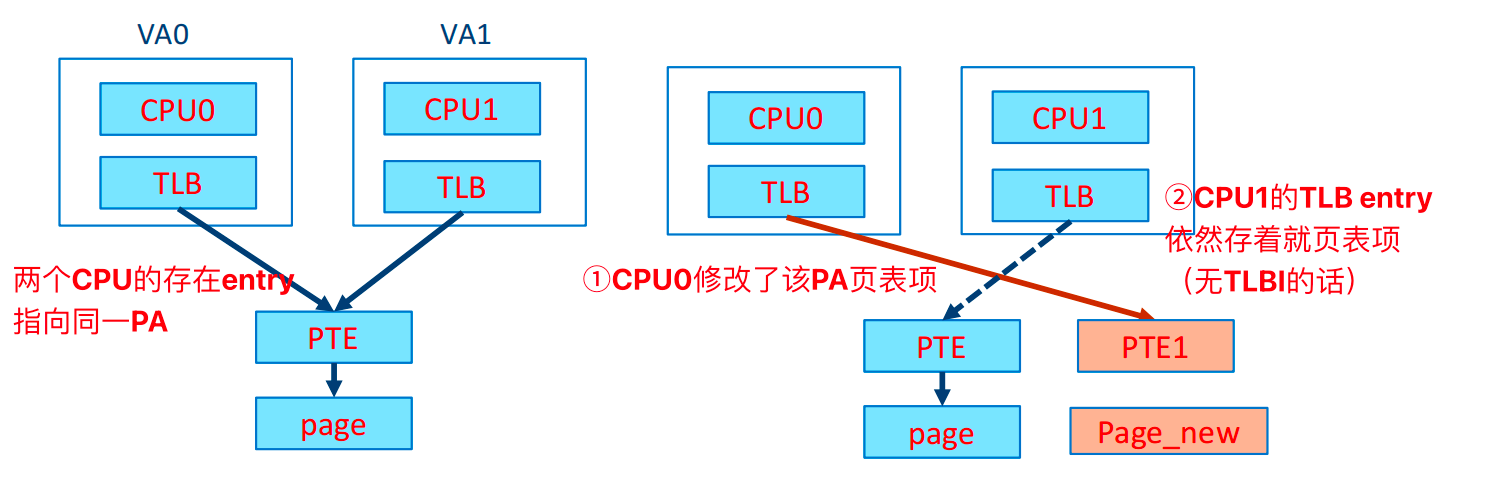
从上图的经典场景我们可以知道,在修改OA的场景下,如果不按 BBML0 的规则,此时 CPU0 已经修改了 VA 指向的 PA,而且也还没刷 TLBI,那么 CPU1 此时会命中旧的 TLB entry,进而踩空。
那么我们可以画一张图,来推导严格的 BBML0 规则下,同样是两个 cpu 竞争的场景,CPU1 在 BBML0 6 个步骤中任意一步骤去访问这个 VA 时,为什么绝对没问题:
交互演示:逐步推导 CPU1 在 BBML0 七个时间点(① 之前 + 五个步骤间隙 + ⑥ 之后)访问该 VA 的安全性。每步展示两种 TLB 状态下的结局:
1.5 哪些修改需要 BBM (RWHZWS)
并非任何写 PTE 都需要走 BBM 序列。按旧值 → 新值的写模式分四种情形:
| 写 PTE 的情形 | 需要 BBM? | 需要 TLBI? | 依据 |
|---|---|---|---|
| invalid → valid(建立新映射) | 否 | 否 | IWZCBG:fault entry 从不被缓存 |
| 只改权限位(AP/XN/S2AP) | 否 | 是(改后刷) | RWHZWS 清单不含;RGPPYH |
| 改 OA / 内存类型 / 粒度(block↔︎table) / global 重叠 | 是 | —(六步自带) | RWHZWS 四项 |
| valid → invalid(unmap) | 否 | 是 | RGPPYH |
RWHZWS(必须 BBM 的场景清单):多线程共用页表时,以下四类修改必须走 BBM 序列:
| 必须走 BBML0 的页修改场景 |
|---|
| 内存类型 / Shareability / Cacheability 变化 |
| OA 变化,(新 OA 与旧 OA 的内存内容不一致,此时如果有 CPU 去访问旧 OA,就会导致踩空) |
| 块大小变化(smaller↔︎larger,如 L2 Table↔︎Block 互换)——前提是 FEAT_BBML1/2 未实现 |
| 创建 global entry 且可能与 TLB 中已有的非-global entry 重叠 |
权限变化为什么不需要 BBM?
权限修改走 make-then-flush(先建后刷),与 BBM 方向相反(flush-then-make(先断后建))。
可以后刷的原因:
- 新旧 entry 指向同一个 OA、同样的内存类型,唯一差别是权限,不会 multi-match
- 但仍需要 TLBI:TLB 无硬件一致性(RFFWJK),其他核的旧权限 entry 需要软件驱逐
代码佐证——stage2_attr_walker() 原地改权限,不走
break/make:
1 | kvm_pgtable_stage2_wrprotect() // 脏页跟踪写保护 |
1.6 TLBI、DSB 与 ISB
TLBI(TLB Invalidation): ARM 的 TLB 维护指令族,软件操作 TLB 的唯一接口,只能驱逐缓存 entry,不能读、不能写入。本文频繁使用的几种:
TLBI IPAS2E1IS: 按 IPA 无效化 stage2 entryTLBI VMALLE1IS: 无效化 EL1&0 翻译 regime 的全部 entry- IS 后缀 = Inner Shareable,广播到共享域内所有 PE
- range 版(FEAT_TLBIRANGE): 按地址范围批量无效化
DSB(Data Synchronization Barrier):它之前的所有内存访问全部完成之前,后续指令不执行。页表是 Inner Shareable 的,所以用
DSB ISH(覆盖共享该页表的所有核)。六步里三处 DSB 分别保证:② invalid entry 可见 → ④ TLBI 驱逐完成 → ⑥ 新 entry 可见。ISB(Instruction Synchronization Barrier):丢弃流水线中已预取的指令,之后的指令重新取指。用于改系统寄存器后(VTTBR/TCR/SCTLR)让修改对后续执行生效。
一句话:DSB 管数据访问完成,ISB 管取指上下文同步。
二、BBML0~BBML3 四级规范
2.0 四级总览
先看全貌,四级优化各自做了什么:
| 维度 | BBML0 | BBML1(nT 方案) | BBML2 | BBML3 |
|---|---|---|---|---|
| multi-entry 共存 | 不允许 (软件杜绝) | 不允许(nT 只允许 walk 但不再缓存 + TLBI 清旧 = make时零副本) | 允许(硬件消解) | 允许(硬件消解) |
| TLBI 次数 | 1 次,B-TLBI-M | 1 次(nT 期间,零副本替换) | 1 次,make 后 | 1 次,make 后 |
| fault 窗口 | 有([④, ⑤) 期间 Translation Fault) | 无(Valid 恒 1) | 无 | 无 |
| multi-hit abort | — | — | 可能 | 禁止 |
| 额外代价 | fault 处理抖动 | nT 期间每次访问都 walk | 无 | 无 |
硬件检测:CPU 的 BBM 支持级别由
ID_AA64MMFR2_EL1.BBM(bits [55:52])报告:
| 编码 | 级别 | 含义 |
|---|---|---|
| 0b0000 | BBML0 | 必须使用 BBM 序列 |
| 0b0001 | BBML1 | Level 1:支持改 block 大小 |
| 0b0010 | BBML2 | Level 2:支持改 block 大小 |
| 0b0011 | BBML3 | Level 3:支持改 block 大小 |
其中,RPVTFW 规定,BBML1/2/3 的全部优化只覆盖两类场景:块大小变化 or Contiguous bit 变化(本文暂未研究 Contiguous)的场景,其他三类修改(内存类型/OA/global 重叠)在任何硬件上(包括 BBML3),都只能走 BBML0 六步序列。
- 以 BBML2 为例,因为块大小变化不改变 OA,也不改变重要的属性位,VA 映射到 OA 的关系不变,所以可以允许新旧 entry 同时存在于 TLB 中(先 make 再 TLBI),硬件可以消解 multi-hit,make 后访问到旧 entry 也是无害的。
- 而像修改 OA 这种,如果先 make 的话,旧 entry 仍然存在于 TLB 中,make 后访问旧 OA 的 CPU 会踩空/踩错,所以必须走严格 BBML0。
2.1 BBML0:六步纯软件序列
即 1.4 节的 RDDMVT 六步。软件承担全部同步责任:
- invalid → DSB → 广播 TLBI → DSB → Make → DSB
- 保证任意时刻系统里同一地址只有一份有效翻译。
交互演示:逐步体验 BBML0 六步序列(merge 场景:4KB→2MB)——Break(invalid→DSB→TLBI→DSB) 到 [④,⑤) fault 窗口,再到 Make(写新 entry→DSB):
2.2 BBML1:nT 位方案(内核未实现)
nT 位的 spec 定义:
nT 在 VMSAv8-64 的 Block descriptor(bit[16])中,其中,Table descriptor 和 L3 Page descriptor 没有 nT位。
nT 的语义本质: nT 允许一个 valid 的 Block descriptor 参与页表 walk 翻译,但不允许在 nT=1 期间将 walk 的结果缓存到 TLB 中(当然,TLB 中旧的 entry 它管不了,所以旧 entry 在 make 之前依然可以安全使用)。
相关 spec 规则:
- IXPRKH(nT 的保证):nT=1 期间改变 table/block 大小,由该 entry 翻译的访问不会破坏一致性/排序/单处理器语义,也不会导致 Exclusive monitor 清除失败;
- RMRRPW(nT 的代价之一):nT=1 时是否报 Translation fault 由实现定义;不报 fault 仍可能 TLB conflict abort;
- IDXRJK(nT 的代价之二):nT=1 期间翻译性能可能显著受损——每次访问都要重新 walk、不被缓存,所以 nT 只能是过渡态,用完要清掉。
软件序列(四步,一次 TLBI):
与 BBML0 的"先断旧再建新"不同,BBML1 全程 Valid=1——靠 nT 管"未来"+ TLBI 清"过去",让替换瞬间系统零副本:
- ① 旧 entry 置 nT=1:Valid 保持 1,翻译仍有效。nT=1 阻止后续 walk 结果进入 TLB(但不删除已有缓存);
- ② 广播 TLBI:驱逐已缓存的旧 entry。这是唯一一次 TLBI——清"过去";
- ③ DSB:确保 TLBI 全域完成。此后 TLB 空,但 walk 仍可读到 valid 的旧 entry(翻译有效、不缓存)——空窗期无 fault;
- ④ 原子替换 + nT 1→0:把旧 descriptor 替换为新 descriptor(如 Table↔︎Block),同时把 nT 清回 0。替换瞬间系统零副本,不会 multi-hit。替换后新 walk 开始正常缓存新 entry。
TLB 状态时间线与空窗期:
| 时间段 | TLB 里有什么 | 访问走哪条路 | 有选哪个问题吗? |
|---|---|---|---|
| ① nT=1 之后、② TLBI 之前 | 只有旧 entry(nT 不删已有缓存) | TLB 命中旧 entry | 没有(TLB 只有一种) |
| ② TLBI 之后、④ 替换之前 | 空(旧的被驱逐,nT 阻止新的被缓存) | TLB miss → walk → valid 但不缓存 | 没有(TLB 空) |
| ④ 替换之后 | 空,开始填新 entry | miss → walk → 新 entry 被缓存 | 没有(只有新的一种) |
即:TLBI 清"过去"(已缓存的旧副本),nT 管"未来"(空窗期内 walk 不许重缓存)——两者配合让替换(④)发生的瞬间系统零副本。性能差(IDXRJK)的原因是空窗期每次访问都要 walk、TLB 不填充。
交互演示:逐步体验 BBML1 nT-first 序列(merge 场景:4KB→2MB)——从置 nT 到空窗期(无 fault,walk 不缓存),再到原子替换:
2.3 BBML2:硬件容忍 multi-hit
RKFLJB 第三条:软件直接改页表(make)、不 invalid、不用 nT、只有make后一次TLBI,硬件保证不破坏一致性/排序/单处理器语义/Exclusive monitor。
🎬 交互演示:点击下方动画,逐步体验初始稳态 → 直接改页表 → walk 填充新 entry → multi-hit的全过程:
multi-hit 时硬件返回哪条?
| 级别 | multi-hit 可能性 | 允许行为 | 关键约束 |
|---|---|---|---|
| BBML2 | 正常使用就会 | abort / 与任一 entry 一致 | 禁止融合 |
| BBML3 | 正常使用就会 | 只允许一致结果 | abort 被禁止 |
- 择优返回:架构不规定返回旧还是新,只保证返回的是某一条 entry 的完整翻译;因为 BBML2 的前提是 RPVTFW(OA 和属性都没变,只变了粒度),旧 2MB 和新 4KB 的 OA + 属性本就一致,返回哪个都正确;
- abort:不返回:abort 是报 TLB conflict abort 异常,访问以异常结束。
靠最终 TLBI 实现收敛:
BBML2 不禁止 TLB conflict abort(IHYQMB:不 TLBI 则可能 abort),所以收敛仍然要靠软件的最终 TLBI 或自然淘汰。最终 TLBI 清掉新旧并存的所有 entry。
对比:BBML0 六步里的 TLBI(第③步)只清旧 entry(因为新 entry 还没写入);
BBML2/3 的最终 TLBI 清新旧全部(因为新 entry 早在直接写入时就进了 TLB)。
适用场景:仅限改 table/block 大小(双向)或 Contiguous bit 修改。内存类型/OA 变化等任何级别都必须走完整 BBM(RWHZWS 不豁免)。
2.4 BBML3:BBML2 + 永不 abort
BBML3 在 BBML2 基础上额外保证 multi-hit 时永不产生 TLB conflict abort——硬件只能返回与任一编程值一致的结果。
为什么 noabort 是刚需?
- 内核的大量关键路径(缺页处理、mTHP 折叠/展开)本身就运行在 abort 处理上下文中;
- 这些路径里若触发 TLB conflict abort,就是递归 abort,无法恢复;
- Mikołaj patch 2 的 commit message 说得直白:"Not causing aborts avoids us having to prove that no recursive faults can be induced in any path that uses BBML2, allowing its use for arbitrary kernel mappings."(防止递归 abort,从而允许BBML2用于任意内核映射)
BBML3 的流程:与 BBML2 完全一致(直接写入新 entry → 最终 TLBI 或自然淘汰),唯一区别是窗口期 multi-hit 时硬件不会 abort。
🎬 交互演示:逐步体验 BBML3 流程——直接改页表 → multi-hit → 对比 BBML2(可能 abort) vs BBML3(永不 abort) → 最终 TLBI 收尾:
2.5 场景×级别支持矩阵
开发者视角的最终速查表——我要改这种 PTE,这块硬件上能走什么路径:
| # | 修改场景 | BBML0 | BBML1 | BBML2 | BBML3 | 依据 |
|---|---|---|---|---|---|---|
| A | 级别无关——本来就不需要 BBM | |||||
| 1 | 建立新映射(invalid→valid) | 免 TLBI,仅需 ISB | 同左 | 同左 | 同左 | IWZCBG |
| 2 | unmap(valid→invalid) | 仅 TLBI | 同左 | 同左 | 同左 | RGPPYH |
| 3 | 权限变化(AP/XN/S2AP) | make-then-flush | 同左 | 同左 | 同左 | RWHZWS 不含 |
| B | 级别无关——必须完整 BBM | |||||
| 4 | 内存类型/SH/Cacheability 变化 | 六步 BBM | 同左 | 同左 | 同左 | RWHZWS |
| 5 | OA 变化(迁移/COW/KSM) | 六步 BBM | 同左 | 同左 | 同左 | RWHZWS |
| 6 | global 与非 global 重叠 | 六步 BBM | 同左 | 同左 | 同左 | RWHZWS |
| C | 仅有的两类随级别放松 | |||||
| 7 | 块大小变化(拆/合大页,L1/L2) | 六步 BBM | 六步 或 nT 方案 | 直接改+最终 TLBI(仍可 abort) | 直接改+最终 TLBI(永不 abort) | RKFLJB |
| 8 | Contig bit 变化(Block/Page) | 六步 BBM | 直接翻(仍可 abort) | 直接翻(仍可 abort) | 直接翻(永不 abort) | RKHRBC;RFCPSG |
三段的读法:
- A 段(行1~3)与硬件级别无关——本来就不需要 BBM,四级完全一致;
- B 段(行4~6)是 RPVTFW 的规则化含义——BBML 优化完全不覆盖,即使 BBML3 也只能走 BBML0 六步;
- C 段(行7~8)是 BBML1/2/3 全部优化所在——且只有这两行;行8 是唯一 L3 Page descriptor 也受益的行(机制见 2.2 双机制分析)。
第三、四章的案例全部落在 C 段:KVM stage2 拆大页 = 行7 的 BBML0 列软件实现;contpte fold/unfold = 行8 的 BBML3 列硬件方案。
三、BBML0 的完整实现:KVM stage2 拆大页
KVM 不检测硬件 BBM 级别,无条件走 BBML0 六步,在任何硬件上都正确。
RFC 预览:社区已有 KVM 侧 BBML3 的 RFC(Mostafa Saleh / Google,两个 patch),未合入主线——见第五章。
KVM 的 stage2 是 PE MMU 的第二级翻译:VTTBR_EL2 指向页表,由 EL2 软件管理、PE 硬件遍历——所以前文所有 ARM规则直接适用。
- 策略:KVM 不检测
ID_AA64MMFR2_EL1.BBM,无条件按 BBML0 假设实现——在任何硬件上都正确,代价是每次拆页的 TLBI 开销和 fault 窗口; - 嵌套虚拟化:KVM 还向 Guest 隐藏该字段(nested.c 的
limit_nv_id_registers强制 Guest 看到 BBM=0),因为 S1/S2 由不同实体管理时 BBM 保证无法跨级维护。
注意:KVM stage2 有两个非 BBML 的 TLB 优化——
stage2_unmap_defer_tlb_flush()(延迟到 walk 结束用 range 版 TLBI 批量刷)和kvm_tlb_flush_vmid_range()(range 版代替逐条)。这些是 TLB 指令层面的优化,不是 BBM 级别放松。
3.1 触发场景
最常见的是热迁移脏页跟踪的 eager
split:用户态(QEMU)通过 KVM_SET_USER_MEMORY_REGION
开启 memslot 脏页跟踪 → 脏页位图是 4K 粒度,2MB block 无法提供 →
必须预先把所有大页拆成 4K:
1 | kvm_mmu_split_memory_region() // mmu.c, eager split 入口 |
3.2 BBM 代码实现:stage2_try_break_pte + stage2_make_pte
stage2_split_walker 是拆页的核心 walker,它把 RDDMVT
六步序列浓缩为 break + make
两步——create_unlinked() 预建离线子树只是把 ⑤
的准备工作提前做掉,与 ①~④ 断旧解耦:
1 | /* linux/arch/arm64/kvm/hyp/pgtable.c */ |
stage2_try_break_pte 把 RDDMVT 的 ①~④
压进一个函数——invalid 写 + TLBI + DSB,注意 invalid entry 的编码用
bits[63:60]:
1 | /* linux/arch/arm64/kvm/hyp/pgtable.c */ |
几个要点:
- LOCKED invalid PTE 一石二鸟:bits[63:60]=1 同时是
BBM 的 ①(Valid=0 断旧翻译)和 KVM 的软件锁(其他 walker 看到 LOCKED 就
return -EAGAIN退让); - TLBI 粒度自适应:旧 entry 是 table →
kvm_tlb_flush_vmid_range(range 版,刷整棵子树的 walk cache);旧 entry 是 block/page →__kvm_tlb_flush_vmid_ipa(单页版); SKIP_BBM_TLBI的真实语义:create_unlinked()建的离线子树没有任何 live entry 指向它,硬件 walk 从 VTTBR 走不到 → 不可能有 TLB entry / walk cache 引用 → 跳过 TLBI 是无引用逻辑,与硬件 BBM 级别无关,在 BBML0 上同样成立。KVM 是彻底的 BBML0 软件方案;smp_store_release:⑤ 写新 Table entry 时用 release 语义,保证新子树内容(512 个 PTE)先于 Table entry 对其他 PE 可见——否则 PE 可能看到 Table entry 指向的新页表页,但里面还是空的。
与 RDDMVT 六步的映射:
| RDDMVT | KVM 实现 |
|---|---|
| 1. 置 invalid | stage2_try_set_pte(locked_pte),bits[63:60] 编码
LOCKED |
| 2. DSB(可见性) | 折叠进 hyp 调用边界 + 后续广播 TLBI 语义 |
| 3. broadcast TLBI | __tlbi_level(ipas2e1is);table entry 用
kvm_tlb_flush_vmid_range |
| 4. DSB(完成) | __kvm_tlb_flush_vmid_ipa 内 dsb(ish) |
| 5. 写新 entry | stage2_make_pte → smp_store_release |
| 6. DSB(可见) | kvm_pgtable_stage2_split 结尾
dsb(ishst) |
3.3 __kvm_tlb_flush_vmid_ipa:TLBI 的硬件细节
1 | /* linux/arch/arm64/kvm/hyp/vhe/tlb.c */ |
代码注释解释了为什么连 S1 一起刷:另一个 CPU 可能基于旧 S2 映射补全一次 S1+S2 完整 walk 并回填 TLB,所以组合翻译的缓存副本必须整体失效(RRVJDB:TLB entry 包括组合 S1+S2 信息的结构)。
四、BBML3 在主线内核中的实现
本章按级别逐一解析内核代码——发现 BBML1 被完全跳过、BBML2 仅 SMMU 侧检测、BBML3 是 CPU 侧主力。先看全貌:
| # | 场景 | 函数 | 优化内容 | 侧 |
|---|---|---|---|---|
| 1 | mTHP contig PTE 折叠/展开 | contpte_convert() |
跳过中间 TLBI(最核心场景) | CPU MMU(stage1) |
| 2 | 线性映射三件套 | force_pte_mapping() /
arch_kfence_init_pool() /
linear_map_split_to_ptes() |
保留 block mapping + 拆页后跳过 TLBI + 混合拓扑握手 | CPU MMU(stage1) |
| 3 | SMMU SVA | arm_smmu_sva_supported() |
CPU+SMMU 双侧 noabort 才启用(共享页表时 multi-hit 不 abort) | SMMU + CPU MMU |
前 3 项都由
system_supports_bbml3()判断是否启用,主线已合入;KVM BBML3 RFC 见第五章。
4.1 BBML1:被跳过的一级(无内核实现)
sysreg 定义了 BBML1 但内核从不用它。
内核从 BBML0(软件 6 步)直接跳到 BBML2_NOABORT(现 BBML3),完全跳过 BBML1。原因:
- 性能差:nT=1 空窗期每次访问都 walk 且不缓存(IDXRJK)——比 BBML2/3 的直接改差一个数量级;
- 安全不足:BBML1 的 Contig 放松仍可能产生 TLB conflict abort(RFCPSG)——内核缺页处理等路径运行在 abort 上下文中,递归 abort 无法恢复;
- BBML2/3 严格优于 BBML1:免 nT、免中间 TLBI,BBML3 还额外消除 abort——没有任何场景会让内核选 BBML1。
4.2 检测:cpu_supports_bbml3()
1 | // arch/arm64/kernel/cpufeature.c |
为什么要逐 CPU 本地检测?
- 检测依据是 MIDR(非 sanitised 寄存器),SMP 启动完成后统一检查的方式不适用;
- 新类型要求每个 early CPU 本地检查、全部满足才启用;late CPU 必须具备该特性;
- 能力表项
ARM64_HAS_BBML3,type =ARM64_CPUCAP_EARLY_LOCAL_CPU_FEATURE。
erratum 3683289:C1-Ultra/C1-Premium 在受影响修订版上不遵守 BBM 会触发 livelock,白名单只放行 r1p1+——说明 MIDR fallback 不只是信任清单,每款 CPU 还要逐个核对微架构 bug。
4.3 使用场景①:contpte_convert()——mTHP contiguous PTE 折叠/展开
这是 BBML3 最核心的使用场景。
contpte_convert() 同时服务 fold(N 个非 contig PTE → 1 个
contig block)和 unfold(反向):
1 | /* linux/arch/arm64/mm/contpte.c */ |
BBML3
在代码中的体现:if (!system_supports_bbml3())
是唯一的分支点——BBML3 系统跳过中间 TLBI,直接从 invalid
重绘成 contig block;非 BBML3 系统必须先 __flush_tlb_range()
再重绘。
跳过的正确性(内核注释引 RNGLXZ/RJQQTC):
- 跳过后旧的单页 entry 和新的 contig entry 可能同时存在于 TLB——不同 Tag(4KB vs 64KB contig)所以能共存;
- multi-match 时,BBML3 硬件只返回一致结果、绝不融合、永不 abort;
- 调用者对变更页的最终 TLBI 清掉新旧;其余 stale entry 靠自然淘汰。
TLBF_NOWALKCACHE:只刷 TLB entry、不动 walk cache——contig
位变化不改变层级结构,walk cache 无需无效化。
4.4 使用场景②:线性映射三件套
线性映射(linear map)是内核把全部物理内存映射到 VA 的那棵页表,通常用 2MB/1GB block 建以减少 TLB 压力。但有些子系统需要 4KB 粒度的操作——它们面临的共同问题是:怎么把已有的 block 拆成 PTE。BBML3 让这个拆分不再需要 BBM 六步。
① force_pte_mapping()——启动时就全 PTE 化
- 场景:
debug_pagealloc、KFENCE、Realm CCA 等子系统需要在运行时修改单个页的权限(如设只读、设 guard page)。如果线性映射用的是 2MB block,改单页权限前必须先拆 block→PTE。 - 无 BBML3:拆 block→PTE 是块大小变化,需要 BBML0
六步——太贵。所以内核在启动时直接把整棵线性映射建为
PTE(
force_pte_mapping()返回 true →NO_BLOCK_MAPPINGS),以后改权限只动单个 PTE,不需要 BBM。代价是线性映射全 PTE 后 TLB 压力大。 - 有 BBML3:
force_pte_mapping()返回 false,线性映射保留 block mapping。需要改单页权限时再按需拆——BBML3 保证拆分时新旧 entry 并存不 abort,所以不需要 BBM 六步。
1 | /* linux/arch/arm64/mm/mmu.c */ |
② KFENCE pool 初始化——拆页后跳过 TLBI
- 场景:KFENCE 是内存错误检测器,需要把它的 pool 区域从 block 拆成 PTE(每个 4KB 页独立管控)。
- 无 BBML3:拆后必须 TLBI 驱逐旧的 block entry,否则 multi-hit。
- 有 BBML3:拆后不做 TLBI——内核注释原文:"larger entries may safely linger in the TLB"(旧的大 entry 留在 TLB 里是安全的)。BBML3 保证 multi-hit 时硬件返回一致结果,旧 block entry 和新 PTE entry 并存不出错。
1 | /* linux/arch/arm64/mm/mmu.c */ |
③ KPTI 混合 CPU 拓扑——boot CPU 有 BBML3、secondary 没有
- 场景:异构系统中 boot CPU 支持
BBML3(
force_pte_mapping()返回 false → 线性映射用了 block),但某些 secondary CPU 不支持(system_supports_bbml3()返回 false)。non-BBML3 的 CPU 无法容忍 block→PTE 的块大小变化,所以必须在它们看不到的时候把线性映射全拆成 PTE。 - 解法:boot CPU 趁 secondary 被锁在 idmap
中时执行拆分——secondary 的 MMU 走的是
idmap(恒等映射),不碰线性映射,对拆分无感知。
idmap_kpti_bbml3_flag是握手变量:boot CPU 设 flag=1 → secondary 各自cpu_install_idmap()后自增 flag → boot CPUsmp_cond_load_acquire等 flag == num_online_cpus()(全部 secondary 就位)→ boot CPU 执行range_split_to_ptes()→ 设 flag=0 释放 secondary。
1 | /* linux/arch/arm64/mm/mmu.c */ |
boot CPU 能做拆分是因为它有 BBML3——拆分时新旧 entry 并存不 abort。拆完后线性映射全 PTE,secondary 以后不再遇到块大小变化,BBML3 缺失不影响。
4.5 使用场景③:SMMU SVA
SVA(Shared Virtual Addressing)让 SMMU(IOMMU)和 CPU 共用同一套页表做地址翻译——DMA 设备直接用进程的 VA 访问内存,不需要 pinned buffer。这带来一个 BBML3 特有的要求:CPU 和 SMMU 共享页表时,任一方修改 PTE 会同时影响两条翻译路径。
- 问题:CPU 改了一个 PTE(比如 unmap 一页),SMMU 可能正在用旧翻译做 DMA walk。如果 SMMU 遇到 multi-hit 时 abort(BBML2 行为),DMA 流就断了——设备不会像 CPU 那样走 fault handler 重试,直接挂死。所以 SVA 要求 multi-hit 永不 abort。
- 启用条件:
arm_smmu_sva_supported()要求 CPU 侧和 SMMU 侧都满足 noabort 才开 SVA:
1 | /* linux/drivers/iommu/arm/arm-smmu-v3/arm-smmu-v3-sva.c */ |
- SMMU 侧检测:SMMU
IDR3.BBM==2时保证F_TLB_CONFLICT永不发生——SMMU spec 的 BBML2 等价于 ARM ARM 的 BBML3(noabort)。驱动在arm_smmu_device_probe()中读 IDR3 设ARM_SMMU_FEAT_BBML2。 - 为什么双侧都要:共享页表意味着 PTE 变更同时影响 CPU MMU 和 SMMU 的翻译。只有双侧都 noabort,才能保证无论哪一方遇到 multi-hit 都不 abort——否则一次普通的 unmap 就可能让 DMA 挂死。
五、KVM BBML3 RFC
社区已有 KVM 侧 BBML3 支持的 RFC(Mostafa Saleh / Google,两个 patch):
8c44dbf89352— 把stage2_try_break_pte()中的 TLBI + put_page 逻辑抽取成独立函数stage2_clean_old_pte()。BBML0 路径行为不变,只是为了让 BBML3 路径能复用这段逻辑;5adaf55fb3bd— 新增stage2_use_bbml3()判断 +stage2_try_break_pte()/stage2_make_pte()双路径。
5.1 为什么 BBML3 需要三个条件
BBML3 的替换序列是 make-first:先 cmpxchg 原子写入新
PTE(Valid 恒 1),再 TLBI 驱逐旧 entry。但 KVM 在写入新 PTE
之前必须做 CMO(Cache Maintenance Operation,如
dcache_clean_inval_poc 清
D-cache、icache_inval_pou 清
I-cache),保证新映射页的缓存状态正确。
问题出在并发:BBML0 用 LOCKED 软件锁先锁住 PTE,其他 walker
看到锁就退让,CMO 不会重复。BBML3 用
cmpxchg——只有在替换失败时才知道有并发,而此时
CMO 已经做过了,另一个并发 walker 也会做一遍同样的 CMO,产生冗余
CMO。
stage2_use_bbml3() 用 FWB + DIC 两个特性把 CMO 变成
NOP,绕开这个问题:
1 | /* linux/arch/arm64/kvm/hyp/pgtable.c (RFC) */ |
- FWB(FEAT_FWB):Stage2 的 cache
属性由硬件强制管理,
stage2_pte_cacheable()下的 D-cache CMO 变成空操作; - DIC(FEAT_DIC):I-cache
硬件自动维护一致性,
icache_inval_pou变成空操作。
两个都满足时,所有 CMO 都是 NOP,cmpxchg 并发产生的冗余 CMO
不再有实际开销。内核注释原文(kvm_mmu.h):"With S2FWB and
CACHE DIC features, KVM need not do cache flushing and CMOs are
NOP'd."
5.2 新序列:Make-first + TLBI 后置
| 步骤 | BBML0(软件六步) | BBML3(RFC 新序列) |
|---|---|---|
| ① | 旧 entry 置 invalid(Valid=0) | get ref on new PTE(新页引用计数+1) |
| ② | DSB | cmpxchg 原子替换 PTE(Valid 恒 1) |
| ③ | 广播 TLBI | TLBI(驱逐旧 entry) |
| ④ | DSB | drop ref on old PTE(旧页引用计数-1) |
| ⑤ | 写新 entry | — |
| ⑥ | DSB | — |
| fault 窗口 | 有([④,⑤) 期间 Translation Fault) | 无(Valid 恒 1,翻译不中断) |
| 并发控制 | LOCKED(bits[63:60] 软件锁) | cmpxchg 失败即 -EAGAIN 重试 |
BBML3 把 BBML0 的"先断旧再建新"翻转成"先建新再断旧"——因为硬件保证 multi-hit 不 abort,所以新旧 entry 短暂并存是安全的。TLBI 从 Break 阶段挪到了 Make 之后(后置),驱逐不再需要的旧 entry。
5.3 代码路径
BBML0 路径下 break 做 invalid+TLBI,make
只写新值。BBML3 路径翻转:break
直接返回(跳过),make 做 cmpxchg+后置 TLBI。
stage2_try_break_pte() 在 BBML3 下直接返回 true(不做
break):
1 | /* linux/arch/arm64/kvm/hyp/pgtable.c (RFC) */ |
stage2_make_pte() 在 BBML3 下走 make-first:cmpxchg
原子替换 → 成功后调 stage2_clean_old_pte() 做后置 TLBI +
put_page:
1 | /* linux/arch/arm64/kvm/hyp/pgtable.c (RFC) */ |
smp_wmb() 的作用:保证前面的
CMO(dcache_clean_inval_poc 等)在 cmpxchg
之前完成——stage2_try_set_pte() 在非共享 walk 时用
WRITE_ONCE(无 release 语义),不像 BBML0 路径用
smp_store_release。
5.4 前置约束与受益范围
RFC commit message 明确约束:"We assume that KVM will never change the OA of an active translation. If the host needs to move the backing PFN, it should do an explicit unmap to issue the required TLBI."——BBML3 路径不改变活跃翻译的 OA(需要 remap 时走显式 unmap,走传统 BBM0)。这和 2.0 节的矩阵一致:OA 变化在任何级别都必须走 BBML0。
RFC 改的是 stage2_try_break_pte() /
stage2_make_pte() 这对底层原语,所有经过它们的 stage2
场景全部受益:
- map/split(缺页/拆粒度):走 break/make → 受益
- relax_perms(权限放宽):只
try_set_pte原地改 → 不涉及(权限变化不需要 BBM) - unmap:只 clear + defer TLBI → 不涉及
主要受益场景:guest 缺页路径(user_mem_abort →
kvm_pgtable_stage2_map → 拆 block)和热迁移 eager
split。
六、总结
6.1 决策树
表格速查版见 2.5 矩阵,本图是同一决策的流程形态:
6.2 核心结论
- BBM 的本质是驱逐缓存的同步协议:页表 entry 是源头、TLB entry(含 walk cache、walk 临时寄存器)是缓存副本,TLB 没有硬件一致性,软件必须显式维护。
- 权限变化不需要 BBM(只需改后 TLBI),内存类型/OA/global 变化任何级别都不豁免,BBML 系列放开的只有块大小(双向)和 Contiguous bit,且要求 OA 与其他属性完全不变(RPVTFW)。
- BBML1 的 nT 是施工围挡:nT=1 不缓存(管未来)+ TLBI 驱逐旧 entry(清过去),替换瞬间系统零缓存副本;代价是 nT 期间每次访问都 walk。
- BBML2 硬件消解 multi-hit:允许新旧并存,硬件保证 abort 或一致结果、绝不融合;收敛靠最终 TLBI 或自然淘汰。
- BBML3 = BBML2 + 永不 abort 的架构化(2025 Architecture Extensions):内核从 MIDR 白名单信任(BBML2_NOABORT)演进到读 ID 寄存器;abort 上下文不能递归 fault 是 noabort 的刚需。
- KVM stage2 是教科书级 BBML0
实现:
stage2_try_break_pte与 RDDMVT 六步一一对应,LOCKED invalid PTE 一石二鸟(Break + 软件锁),SKIP_BBM_TLBI是无引用逻辑而非 BBML2。 - contpte_convert 是 BBML2/3 的标准用法:跳过中间 TLBI,瞬态 multi-hit 由 RNGLXZ/RJQQTC 兜底,最终 TLBI + 自然淘汰完成收敛。
- multi-hit 是 merge(小变大)方向特有的现象(单 PE 私有 TLB):旧小 entry 盖不住兄弟页的访问,walk 填充新大 entry 后覆盖旧小 entry 的范围,导致同一 VA 双命中。split 方向不会,因为旧大 entry 在场时所有访问都 hit,不会 walk 出新小 entry。